研讨会系列 · KF L19 · 动态规划理论深化 · 第一部分
最优性原理与海盗分钻石
Bellman 最优性原理的严格表述、向后归纳(Backward Induction)思维与海盗分钻石经典案例
📅 2026-07-15
🧩 最优性原理
🏆 向后归纳
🔄 博弈论
🎯 学完本节,你应能
- 用数学语言表述 Bellman 最优性原理
- 理解截断策略(truncated policy)的最优性
- 运用向后归纳(backward induction)求解海盗分钻石问题
- 将最优性原理的直觉与 DP 算法联系起来
🔑 核心思想
最优策略的任何一段子策略也是最优的——这就是 Bellman 最优性原理。本章用海盗分钻石这个博弈论经典案例,让你直观感受"从终局倒推"的向后归纳思维,这是 DP 算法能够将多步决策分解为单步优化的根本原因。
1. 回顾:DP 基本问题
在开始之前,先快速回顾动态规划的基本问题框架。一个离散时间动态系统由以下方程描述:
我们的目标是极小化期望总代价:
$$
J = \mathbb{E}\left\{ g_{N}(x_{N}) + \sum_{k=0}^{N-1} g_{k}(x_{k}, u_{k}, w_{k}) \right\}
$$
策略(policy)定义为各时刻控制律的序列:
$$
\pi = \{ \mu_{0}, \mu_{1}, \dots, \mu_{N-1} \}, \quad u_{k} = \mu_{k}(x_{k})
$$
基本问题可以简化为:在所有可能的策略中找到使总期望代价最小的最优策略 $\pi^{*}$。
2. Bellman 最优性原理的形式化表述
Bellman 最优性原理是动态规划的基石。让我们从直观理解进入严格的数学表述。
🏆 Bellman 最优性原理(直观表述,1957)
一个最优策略具有这样的性质:无论初始状态和初始决策如何,剩余的决策必须构成一个以第一个决策产生的状态为初始状态的最优策略。
2.1 最优策略的截断
设 $\pi^{*} = \{ \mu_{0}^{*}, \mu_{1}^{*}, \dots, \mu_{N-1}^{*} \}$ 是基本问题的一个最优策略。假定在 $\pi^{*}$ 下,某个状态 $x_{i}$ 以正概率出现。
考虑一个子问题:我们在时刻 $i$ 处于状态 $x_{i}$,希望最小化从时刻 $i$ 到 $N$ 的代价:
$$
\mathbb{E}\left\{ g_{N}(x_{N}) + \sum_{k=i}^{N-1} g_{k}(x_{k}, \mu_{k}(x_{k}), w_{k}) \right\}
$$
最优性原理指出:截断后的策略 $\{ \mu_{i}^{*}, \mu_{i+1}^{*}, \dots, \mu_{N-1}^{*} \}$ 对这个子问题也是最优的。
🔄 从 $x_0$ 到终点的最优路径中,从任意中间状态 $x_i$ 到终点的子路径也是最优的。
✅ 为什么成立?
因为代价函数是可加的(分离性)。未来代价只依赖于当前状态和未来决策,不依赖于历史——这就是马尔可夫性质。
⚠️ 一个关键条件
最优性原理要求截断后的子策略对所有可能的状态 $x_i$ 都是最优的。如果某些状态在最优策略下不会出现,我们可以任意定义那些状态的策略。
2.2 路径最优性的直观示例
最优性原理的最经典直观就是最短路径问题:
🌰 从香港到北京的最短路径
假设从香港(HK)到北京(BJ)有一条最短路径,它途经某座城市 $X$。那么从 $X$ 到北京的那一段路径,一定也是从 $X$ 到北京的所有路径中最短的。
反证法:如果从 $X$ 到北京有一条更短的路径,那么把它替换进来,就能得到一条从 HK 到 BJ 的更短路径——与"最短"矛盾。
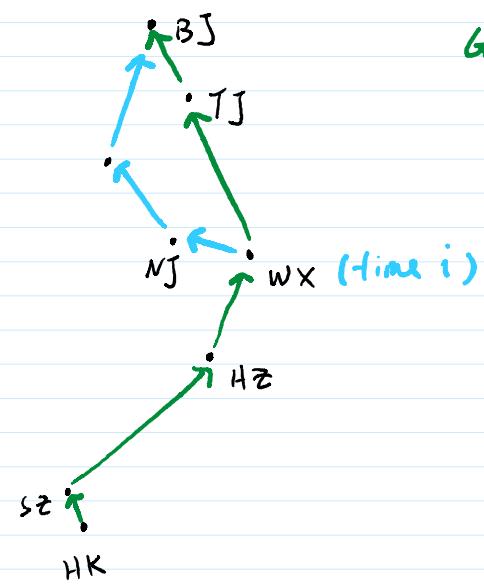 绿色线条为 HK→BJ 的最优路径(最小代价路径)
这个直觉非常朴素,但它的力量是巨大的——它告诉我们不需要穷举所有可能的路径组合,而可以通过"倒着推"的方式逐段构建最优解。
3. 核心案例:海盗分钻石问题
海盗分钻石问题是博弈论中的经典,也是理解 backward induction(向后归纳)的最佳入口。这个问题完美展现了最优性原理在序贯决策中的应用。
3.1 问题设定
🏴☠️ 海盗分钻石
场景:5 个海盗抢到了 100 颗钻石(形状、大小、颜色完全一样,价值相同)。他们需要决定如何分配。
假设:
- 所有海盗都是完全理性(rational)且极其聪明(smart)的
- 每个海盗都希望最大化自己的收益
- 如果收益相同,海盗倾向于杀死别人(即投票反对)
3.2 分配规则
3.3 向后归纳求解(Backward Induction)
我们从最简子问题开始,逐步向复杂情况推导——这正是最优性原理的应用!
🔹 情况 A:只剩 2 个海盗(4 号和 5 号)
此时 4 号提出方案。他只需要自己一票(50%)即可通过。因此他会提出:
4 号:100 颗,5 号:0 颗
4 号自己投票同意(1 票 = 50%),方案通过。5 号得到 0 颗。
🔹 情况 B:3 个海盗(3 号、4 号、5 号)
3 号知道:如果自己的方案被否,他会死,进入"情况 A"——那时 4 号得 100 颗,5 号得 0。
3 号需要拉至少 1 票(加上自己共 2 票 = 66.7%)。给 5 号 1 颗(比情况 A 的 0 颗好),5 号就会同意。
3 号:99 颗,4 号:0 颗,5 号:1 颗
3 号和 5 号同意(2 票 = 66.7%),方案通过。
🔹 情况 C:4 个海盗(2 号、3 号、4 号、5 号)
2 号知道:如果自己被否,会进入"情况 B"——那时 3 号得 99,4 号得 0,5 号得 1。
2 号需要拉至少 1 票。给 4 号 1 颗(比情况 B 的 0 颗好),4 号就会同意。
2 号:99 颗,3 号:0 颗,4 号:1 颗,5 号:0 颗
2 号和 4 号同意(2 票 = 50%),方案通过。
🔹 情况 D(完整问题):5 个海盗(1 号、2 号、3 号、4 号、5 号)
1 号知道:如果自己被否,会进入"情况 C"——那时 2 号得 99,3 号得 0,4 号得 1,5 号得 0。
1 号需要拉至少 2 票(加上自己共 3 票 = 60%)。对比情况 C 的结果:
- 3 号在情况 C 得 0 颗 → 给他 1 颗就会同意
- 5 号在情况 C 得 0 颗 → 给他 1 颗就会同意
- 2 号和 4 号在情况 C 分别得 99 和 1 颗 → 很难收买
1 号:98 颗,2 号:0 颗,3 号:1 颗,4 号:0 颗,5 号:1 颗
1 号、3 号、5 号同意(3 票 = 60%),方案通过!
3.4 向后归纳的结果总表
上述推理可以用一张表格紧凑地展示。每一行代表当前提议者的情况,数字表示该提议者分配给每个海盗的钻石数:
| 提议者 |
海盗 1 |
海盗 2 |
海盗 3 |
海盗 4 |
海盗 5 |
同意票数 |
| 海盗 5(只剩 1 人) |
— |
— |
— |
— |
100 |
— |
| 海盗 4(2 人) |
— |
— |
— |
100 |
0 |
1/2 (50%) |
| 海盗 3(3 人) |
— |
— |
99 |
0 |
1 |
2/3 (66.7%) |
| 海盗 2(4 人) |
— |
99 |
0 |
1 |
0 |
2/4 (50%) |
| 海盗 1(5 人)— 最终答案 |
98 |
0 |
1 |
0 |
1 |
3/5 (60%) |
💡 关键洞察
海盗 1 最终拿到 98 颗钻石——几乎全部!看似最危险的提议者反而获得了最大收益。这就是向后归纳的力量:从终局状态逐级倒推,每个节点只考虑"如何用最小代价争取足够票数"。
这个过程本质上就是 DP 算法:从终端条件(只剩 1 个海盗)开始,反向递推每一阶段的最优策略。
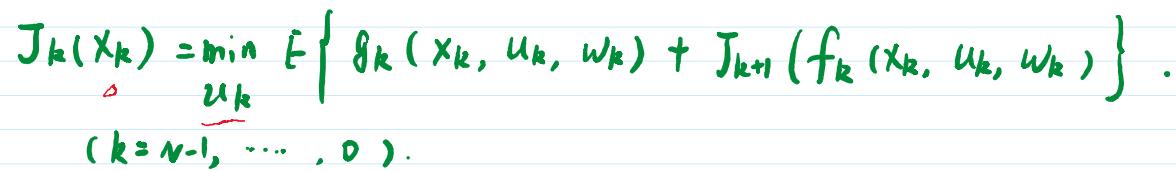
4. 向后归纳的思维框架
海盗分钻石问题展示了向后归纳(backward induction)的核心思维,这与 DP 算法完全一致:
1️⃣ 确定终端状态
从问题的最简"终局"状态开始。在海盗问题中,就是只剩 1 个海盗的情况。
对应 DP:设 $J_{N}(x_{N}) = g_{N}(x_{N})$
2️⃣ 反向递推
在每一步,向前看一步——知道下一步的结果后,当前步的最优选择就变成了一个"单步优化"。
对应 DP:$J_{k} = \min\{ \text{即时代价} + J_{k+1} \}$
3️⃣ 提取最优策略
记录在每个状态下最优的决策(给谁多少钻石)。
对应 DP:提取 $\mu_{k}^{*}(x_{k})$
4️⃣ 正向执行
回到初始状态,按提取的策略执行。海盗 1 提出 (98, 0, 1, 0, 1),获得通过。
对应 DP:查表执行最优控制
🧠 与最优性原理的联系
海盗分钻石的完整推理过程,就是对最优性原理最生动的诠释:
- 我们在"情况 C"(4 个海盗)中求出的最优分配,是"情况 D"(5 个海盗)的子策略——最优性原理保证这条子策略就是最优的
- 如果不是这样(即情况 C 中的分配不是最优的),那么海盗 1 就无法正确评估如果自己被否的结果,也就无法做出最优决策
- 这就是最优策略的子策略也最优——整个 DP 算法的理论基石
5. 最优性原理的适用条件
最优性原理并非天然成立,它依赖于两个关键条件:
✅ 可加性(Additivity)
代价函数必须是各阶段代价之和(或可分解为相加形式):
$$
J = g_{N}(x_{N}) + \sum_{k=0}^{N-1} g_{k}(x_{k}, u_{k}, w_{k})
$$
如果代价函数不是可加的(如存在跨阶段约束或乘积形式的代价),最优性原理可能不成立。
✅ 马尔可夫性(Markov Property)
系统的未来演化只依赖于当前状态和当前决策,不依赖于历史:
$$
x_{k+1} = f_{k}(x_{k}, u_{k}, w_{k})
$$
如果系统的未来依赖于完整历史(如 $x_{k+1}$ 依赖 $x_{k-1}$),则不能直接应用 DP。
📌 结论
在满足可加性和马尔可夫性的前提下,Bellman 最优性原理保证:多步决策问题可以分解为一系列单步优化,且这种分解不会丢失全局最优性。这正是动态规划能够在无数领域(控制理论、强化学习、博弈论、运筹学、经济学)发挥作用的根本原因。
📝 练习与自测
练习 1:概念理解
用你自己的话解释 Bellman 最优性原理。为什么在 DP 中它被称为"最优策略的子策略也是最优的"?
点击查看答案
Bellman 最优性原理指出:如果 $\pi^{*} = \{ \mu_{0}^{*}, \mu_{1}^{*}, \dots, \mu_{N-1}^{*} \}$ 是原始问题的最优策略,那么对于任意时刻 $i$ 和以正概率出现的状态 $x_{i}$,截断策略 $\{ \mu_{i}^{*}, \dots, \mu_{N-1}^{*} \}$ 也一定是子问题(从 $x_{i}$ 出发最小化代价)的最优策略。
换句话说:不能存在一个策略,它在前 $i$ 步与 $\pi^{*}$ 相同,但从 $i$ 步以后更优——因为我们总可以用更好的子策略替换,从而得到比 $\pi^{*}$ 更优的全局策略,这与 $\pi^{*}$ 的全局最优性矛盾。
练习 2:规则变化
海盗分钻石问题中,如果将规则改为"严格超过 50% 同意"(即需要 >50% 而非 ≥50%),重新求解向后归纳。海盗 1 的最优分配方案是什么?
点击查看答案
逐步推理:
- 只剩 5 号(1 人):5 号独吞 100 颗。
- 4 号 + 5 号(2 人):需要 >50% 即 2 票。4 号自己一票只有 50%,不够。所以他必须给 5 号至少 1 颗才能争取到 5 号的票。4 号得 99,5 号得 1。
- 3 号 + 4 号 + 5 号(3 人):需要 >50% 即至少 2 票。如果 3 号死,进入"4 号得 99,5 号得 1"的局面。3 号给 4 号 1 颗(比 99 少→不划算),给 5 号 2 颗(比 1 颗多→同意)。3 号和 5 号投票同意。3 号得 98,4 号得 0,5 号得 2。
- 2 号 + 3 号 + 4 号 + 5 号(4 人):需要 >50% 即至少 3 票。如果 2 号死,进入"3 号得 98,4 号得 0,5 号得 2"。2 号给 4 号 1 颗(比 0 好→同意),给 3 号 0(没必要),给 5 号 3 颗(比 2 好→同意)。2 号、4 号、5 号投票同意(3 票 > 50%)。2 号得 97,3 号得 0,4 号得 1,5 号得 2。
- 5 个海盗完整:需要 >50% 即至少 3 票。如果 1 号死,进入"2 号得 97,3 号得 0,4 号得 1,5 号得 2"。1 号给 3 号 1 颗(比 0 好→同意),给 4 号 2 颗(比 1 好→同意),给 5 号 0(太贵了)。1 号、3 号、4 号同意(3 票 > 50%)。海盗 1 得 97 颗。
练习 3:数值计算 — 6 个海盗情形
现在假设有 6 个海盗和 100 颗钻石,规则为原规则(≥50% 同意)。请从后向前推导第 1 个海盗的最优分配方案,并计算出他能获得多少颗钻石。
点击查看答案
逐步向后归纳:
- 6 号(1 人):(100)
- 5 号 + 6 号:需要 ≥1 票(50%)。5 号:(100, 0)。5 号同意。
- 4 号 + 5 号 + 6 号:需要 ≥2 票。对比 5 号方案中 6 号得 0→给 6 号 1 颗。4 号:(99, 0, 1)。4 号和 6 号同意。
- 3 号 + 4 号 + 5 号 + 6 号:需要 ≥2 票。对比 4 号方案中 5 号得 0→给 5 号 1 颗。3 号:(99, 0, 1, 0)。3 号和 5 号同意。
- 2 号 + 3 号 + 4 号 + 5 号 + 6 号:需要 ≥3 票。对比 3 号方案中 4 号得 0、6 号得 0→给 4 号 1 颗、给 6 号 1 颗。2 号:(98, 0, 1, 0, 1)。2 号、4 号、6 号同意。
- 1 号 + 2 号 + 3 号 + 4 号 + 5 号 + 6 号(完整):需要 ≥3 票。对比 2 号方案中 3 号得 0、5 号得 0→给 3 号 1 颗、给 5 号 1 颗。1 号:(98, 0, 1, 0, 1, 0)。1 号、3 号、5 号同意。
答案:海盗 1 获得 98 颗钻石,分配方案为 (98, 0, 1, 0, 1, 0)。